Engineering Note
Kafka 4.4.0: 실패 처리와 복구, 비용 관리의 새 선택지
Kafka 4.4.0의 Share Group DLQ, 랙 인지 파티셔닝, Streams 상태 복구, CIDR ACL, Tiered Storage 지연 업로드를 적용 조건과 함께 정리합니다.
Apache Kafka가 2026년 10월 22일 4.4.0을 출시했습니다. 이번 릴리스에서 눈여겨볼 부분은 반복해서 실패하는 메시지의 처리, Streams의 상태 복구, 네트워크와 저장 비용을 다루는 기능입니다. IP 대역으로 접근 권한을 관리하는 기능도 추가됐습니다.
이 글은 전체 릴리스 노트에서 다섯 가지 변화를 골라, 어떤 운영 문제를 줄이고 어떤 조건에서 효과가 있는지 살펴봅니다. 설정 예시는 해당 기능에 필요한 항목만 발췌했습니다.
| 변화 | 도움이 되는 상황 | 먼저 확인할 조건 |
|---|---|---|
| Share Group DLQ | 실패 레코드를 별도로 조사·재처리 | share.version=2, 대상 토픽 준비와 그룹 설정 |
| 랙 인지 프로듀서 파티셔닝 | 가용 영역 간 전송 비용 절감 | 기본 비활성화, 파티션 선택에 자유가 있는 메시지 |
| Streams 트랜잭션 상태 저장소 | 오류 후 전체 상태 재구축 부담 완화 | 기본 비활성화, 저장소 구현의 지원 여부 |
| CIDR 기반 ACL | IP 대역 단위 권한 관리 | metadata.version이 4.4-IV1 이상 |
| Tiered Storage 지연 업로드 | 로컬·원격 중복 보관 기간 단축 | 시간·용량 조건과 로컬 디스크 여유 |
1. Share Group: 실패 레코드를 DLQ로 보낸다
Share Group은 레코드를 여러 작업자가 나눠 처리하는 Kafka의 큐형 소비 모델입니다. 4.4.0에는 처리하지 못한 레코드를 별도로 모으는 Dead-letter Queue(DLQ) 지원이 추가됐습니다. 작업자가 REJECT로 거부하거나 전달 횟수 한도에 도달한 레코드를 브로커가 DLQ 토픽으로 보냅니다. KIP-1191
이 기능에는 share.version=2가 필요합니다. 그룹 설정인 errors.deadletterqueue.topic.name은 기본값이 빈 문자열이므로 목적지 토픽을 지정해야 합니다. 그룹 설정, 4.4.0의 기능 버전 정의
목적지 토픽도 준비해야 합니다. 기본 설정에서는 DLQ 토픽을 자동으로 만들지 않으며, 이름은 dlq.로 시작해야 합니다. 대상 토픽에는 errors.deadletterqueue.group.enable=true를 설정합니다. 이름 접두사와 자동 생성 정책은 클러스터 설정으로 바꿀 수 있습니다. 브로커 설정, 토픽 설정
원본의 무엇을 남길지도 선택합니다. errors.deadletterqueue.copy.record.enable은 기본 false이므로 원본 위치와 실패 사유 등의 문맥만 기록합니다. 원본의 키·값·헤더까지 복사하려면 이 옵션을 켭니다. 그룹 설정
다만 원본이 보관 기간 만료나 로그 압축(compaction)으로 제거됐다면 복사할 데이터가 없을 수 있습니다. DLQ 기록과 소비 상태 변경은 하나의 원자적 트랜잭션이 아니므로 중복도 가능합니다. 일부 쓰기 오류에서는 DLQ 기록에 실패해도 레코드가 재전달 대상에서 제외되는 Archived 상태로 넘어갑니다. DLQ 쓰기 오류를 관측하고, 중복에 안전한 재처리 절차를 마련해야 합니다. DLQ 처리 및 오류 정책
예를 들어 이미지 변환 작업이라면 실패 원인을 수정한 뒤 원래 작업 ID로 중복 실행을 판단하며 재처리할 수 있습니다. DLQ는 이런 복구 절차의 출발점을 제공합니다.
2. 프로듀서: 같은 랙의 리더를 우선 선택한다
클라우드의 여러 가용 영역(Availability Zone, AZ)에 Kafka를 배치하면 영역 간 전송 비용이 발생할 수 있습니다. 랙 인지 파티셔닝은 기본 파티셔너가 같은 랙에 리더가 있는 파티션을 우선 선택하도록 합니다. 클라우드에서는 랙 값을 AZ와 대응시켜 사용할 수 있습니다. KIP-1123
Kafka 4.4 Java 클라이언트의 프로듀서 설정 예시는 다음과 같습니다. az-a는 브로커의 broker.rack 표기와 일치하는 실제 값으로 바꿉니다.
client.rack=az-a
partitioner.rack.aware=true
기본값은 false입니다. 대표적인 적용 대상은 파티션과 키를 지정하지 않아 어느 파티션으로 보내도 되는 메시지입니다. 키의 해시로 파티션이 정해지는 메시지나 직접 파티션을 지정한 메시지를 자동으로 가까운 곳에 재배치하지 않습니다. 사용자 정의 파티셔너에는 이 설정이 적용되지 않으며, 같은 랙에 사용 가능한 리더가 없으면 전체 사용 가능한 파티션에서 선택합니다. 프로듀서 설정
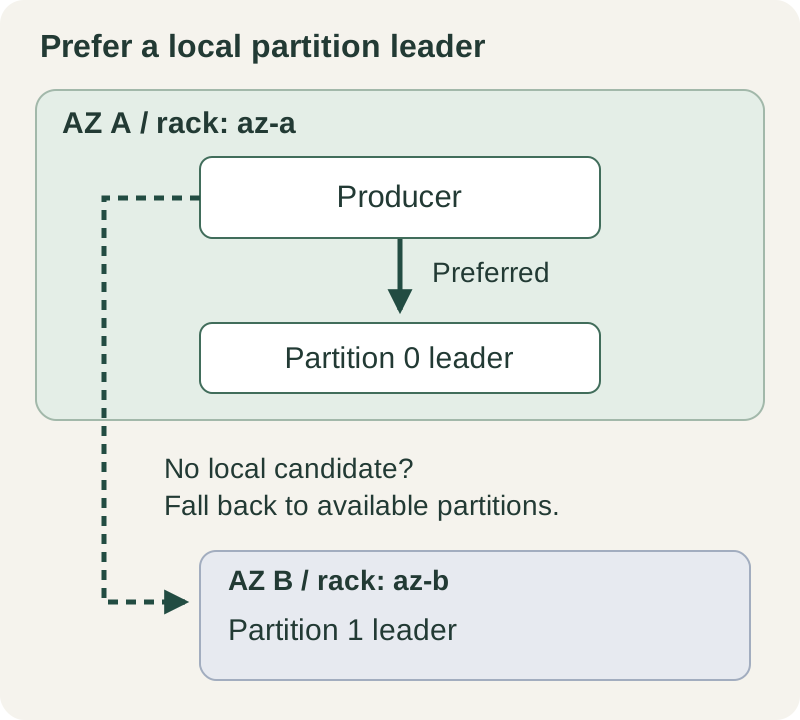
비용 절감과 함께 쓰기 부하의 쏠림도 확인해야 합니다. 프로듀서는 AZ A에 몰려 있는데 리더는 여러 AZ에 고르게 있다면 일부 파티션에 쓰기가 집중될 수 있습니다. 도입 전후에 AZ 간 전송량, 파티션별 입력량, 전송 응답 시간을 함께 비교하는 것이 좋습니다. 브로커 사이 복제 트래픽은 여전히 발생합니다.
3. Streams: 상태 복구 부담을 줄이고 헤더 활용을 넓힌다
Kafka Streams는 집계 결과 등을 로컬 상태 저장소에 보관하고, 변경 내역을 Kafka의 changelog 토픽에 기록합니다. Exactly-Once Semantics(EOS)를 사용하더라도 오류로 두 상태가 어긋나면 로컬 상태를 지우고 다시 만들어야 할 수 있습니다. 상태가 클수록 이 복구 과정이 길어집니다.
트랜잭션 상태 저장소는 쓰기를 버퍼에 모았다가 changelog 트랜잭션 커밋에 맞춰 반영합니다. 지원하는 저장소에서는 오류 후 기존의 커밋된 상태를 유지하고, 마지막 성공한 커밋 이후 작업을 다시 처리할 수 있습니다. KIP-892
다음은 EOS 애플리케이션에서 이 기능과 커밋된 상태의 조회를 함께 평가하는 설정입니다.
processing.guarantee=exactly_once_v2
enable.transactional.statestores=true
default.interactive.query.isolation.level=READ_COMMITTEDenable.transactional.statestores는 기본 false입니다. 상태를 직접 조회하는 Interactive Queries의 기본 격리 수준은 READ_UNCOMMITTED입니다. 위 예시처럼 READ_COMMITTED를 선택하면 새 값은 커밋된 뒤 조회에 나타납니다. 따라서 새 데이터가 조회 결과에 반영되기까지 기다리는 시간이 생깁니다.
버퍼 메모리도 확인해야 합니다. statestore.uncommitted.max.bytes는 애플리케이션 인스턴스별로 기본 64 MiB이며, 미커밋 데이터가 커질 때 조기 커밋을 유도하는 기준입니다. 전체 메모리 사용량의 절대 상한은 아닙니다. 4.4.0의 Streams 설정
이 변화로 모든 장애의 복구 시간이 짧아진다고 단정할 수는 없습니다. 로컬 디스크를 잃거나 상태가 없는 노드로 작업이 이동하면 복원이 필요합니다. 사용자 정의 저장소의 지원 여부도 확인해야 하며, 외부 DB나 API까지 EOS 범위가 확장되는 것은 아닙니다.
헤더 활용도 넓어졌습니다. StreamPartitioner에 헤더를 전달할 수 있고, Interactive Queries v2에는 헤더를 포함한 상태 조회가 추가됐습니다. 헤더를 분기 기준으로 쓰는 애플리케이션에 유용합니다. 다만 기존 람다 구현만으로 새 헤더 인자를 받는 것은 아니므로 인터페이스 구현을 확인해야 합니다. 파티셔너 변경, 헤더 포함 상태 조회
4. ACL: 개별 IP 대신 대역으로 관리한다
기존에는 호스트 조건을 IP 하나씩 또는 *로 관리했다면, 이제 CIDR(Classless Inter-Domain Routing) 표기법으로 IP 대역을 지정할 수 있습니다. ACL(Access Control List)의 --allow-host, --deny-host에 192.168.10.0/24 같은 IPv4 대역이나 IPv6 대역을 사용합니다. IP가 자주 바뀌는 환경에서 개별 주소를 나열하는 부담을 줄일 수 있습니다. KIP-1276
적용에는 metadata.version이 4.4-IV1 이상이어야 합니다. KIP에 남아 있는 초기 버전 표기보다 4.4.0 릴리스 코드의 검사 조건을 기준으로 확인해야 합니다. 브로커 바이너리 교체만으로 활성화됐다고 판단하면 안 됩니다.
대역을 지정하더라도 권한 평가 규칙은 같습니다. 같은 요청에 ALLOW와 DENY가 모두 일치하면 DENY가 우선하며, 더 좁은 대역의 ALLOW가 넓은 DENY를 뒤집지 않습니다. 호스트 조건은 인증된 사용자와 리소스·작업 권한을 대신하지 않습니다. NAT나 프록시가 있다면 브로커가 실제로 보는 출발지 주소를 확인하고, 허용할 서브넷 밖의 요청도 함께 시험하는 것이 좋습니다.
5. Tiered Storage: 원격 업로드 시점을 늦춘다
Tiered Storage는 브로커의 로컬 로그와 원격 저장소를 함께 사용하는 계층형 저장 방식입니다. 세그먼트를 일찍 업로드하면 같은 데이터가 로컬과 원격에 함께 남는 기간이 길어질 수 있습니다. 4.4.0의 지연 업로드는 이 중복 보관 기간을 줄이는 선택지입니다. KIP-1241
Tiered Storage가 이미 활성화된 토픽에서 remote.copy.lag.ms로 시간 조건을, remote.copy.lag.bytes로 용량 조건을 조정합니다. 시간 기본값은 0이므로 기존처럼 더 이상 기록하지 않는 세그먼트가 바로 업로드 대상이 됩니다. 용량 기본값 -1은 로컬 보관 용량 설정을 따릅니다. 두 조건 중 하나를 만족하면 업로드 대상이 되므로, 시간 값을 0으로 둔 채 용량만 바꾸면 원하는 지연이 생기지 않을 수 있습니다. 토픽 설정
예를 들어 전체 보관 기간이 7일, 로컬 보관 기간이 3일이고 용량 제한이 없다면, 업로드를 하루 늦춰 최신 하루치 데이터의 원격 중복 보관을 줄일 수 있습니다. 이때 시간은 세그먼트 내 가장 최근 레코드 타임스탬프를 기준으로 계산합니다. 실제 업로드 대상은 세그먼트 단위로 정해집니다.
업로드가 끝나지 않은 세그먼트는 로컬에서 삭제할 수 없습니다. 지연을 늘린 상태에서 원격 저장소 장애나 업로드 적체가 겹치면 로컬 디스크 압박이 커질 수 있습니다. 원격 사본에 새 데이터가 반영되는 시점도 늦어집니다. 저장 비용만 보지 말고 업로드 지연, 로컬 디스크 여유, 원격 데이터의 허용 지연을 함께 정해야 합니다. 지연 업로드 운영 안내
업그레이드할 때 함께 확인할 것
연결과 배포 설정에도 변화가 있습니다. bootstrap.resolve.timeout.ms를 양수로 설정하면 클라이언트 시작 시 DNS 해석을 비동기로 재시도할 수 있습니다. 기본값은 0이며 Streams와 Connect는 아직 이 모드를 지원하지 않습니다.
Connect에는 internal.topics.automatic.creation.enable=false로 내부 토픽 자동 생성을 막는 설정이 추가됐습니다. 이때 필요한 내부 토픽이 없으면 시작에 실패하므로 배포 전에 준비해야 합니다. 공식 릴리스 발표
운영 적용 전에는 다음을 확인합니다.
- 버전과 기능 수준을 구분한다. 브로커, 컨트롤러, 클라이언트 버전과
metadata.version,share.version을 각각 기록합니다. 기능 수준 변경의 호환성과 되돌릴 수 있는 범위는 별도로 검토합니다. - 인증 설정을 확인한다. JWKS 엔드포인트로 JWT를 검증하는 브로커는 토큰의 대상과 발급자를 검증하는
sasl.oauthbearer.expected.audience와sasl.oauthbearer.expected.issuer를 확인해야 합니다. 기본 검증 정책에서 누락되면 시작에 실패합니다. - 포맷 도구 버전을 맞춘다. 새 저장소를 포맷할 때는 실행할 브로커보다 최신인
kafka-storage.sh를 사용하지 않습니다.--release-version만 낮추는 것으로 이 조건을 대체할 수 없습니다. - 경고와 모니터링을 정리한다.
broker.id와 기존 Yammer 기반 그룹 코디네이터 메트릭이 사용 중단 예정(deprecated)으로 지정됐습니다.node.id사용과 메트릭 이름 전환을 준비합니다. - Streams는 복구와 분배를 함께 시험한다. 오류 후 복구 시간, 버퍼 메모리, 조회 결과의 반영 시점을 측정합니다. 헤더를 받는 직렬화기(serializer)나 시간 윈도 키(windowed key)를 사용한다면 파티션 선택 결과와 조인 대상 토픽의 파티션 정합성(co-partitioning)도 확인합니다.
호환성 변경은 Kafka 업그레이드 안내와 Streams 업그레이드 안내를 기준으로 현재 버전에서의 경로를 확인합니다. Strimzi나 관리형 서비스를 사용한다면 해당 제품의 Kafka 4.4 지원 여부도 별도로 확인해야 합니다.
이번 릴리스는 운영 방식에 따라 얻는 효과가 다릅니다. 실패 레코드 관리가 고민이라면 DLQ를, Streams 복원 시간이 길다면 트랜잭션 상태 저장소를 먼저 평가할 수 있습니다. 전송·저장 비용이 문제라면 랙 인지 파티셔닝과 지연 업로드를 각각 실제 비용 지표와 비교해 보는 것이 출발점입니다.
함께 읽기 좋은 글
- Consumer Group만으로는 Queue가 되지 않는다: Kafka Share Group의 의미 — Share Group의 소비·확인 모델을 먼저 이해하면 DLQ의 역할이 분명해집니다.
- Kafka EOS는 무엇을 한 번만 보장하는가 — 트랜잭션 상태 저장소와 외부 시스템의 멱등성을 구분하는 데 도움이 됩니다.