Engineering Note
관측 데이터는 얼마나 모아야 할까: 수집 비용과 진단 능력의 균형
메트릭·로그·트레이스 수집 비용을 계측부터 저장까지 나눠 보고, 집계·샘플링·레이블·보존 기간으로 필요한 증거를 남기는 운영 기준을 정리합니다.
관측 비용을 줄이려고 로그와 트레이스를 덜 남겼다가, 다음 장애에서 필요한 기록을 찾지 못할 수 있습니다. 저장 비용은 줄었어도 조사 시간과 장애로 인한 손실은 더 커지는 셈입니다. 그렇다고 모든 데이터를 남기는 것이 답은 아닙니다. 중요한 기록을 골라 연결할 수 있어야 합니다.
앞 글에서는 웹 애플리케이션의 느린 구간을 좁히는 방법을 다뤘습니다. 이번에는 그 조사에 필요한 증거를 어느 정도까지 수집하고 보관할지 살펴봅니다. 출발점은 전체 상태를 판단할 기본 통계와, 원인을 조사할 상세 기록의 역할을 나누는 것입니다.
1. 저장량보다 비용이 발생하는 위치를 먼저 본다
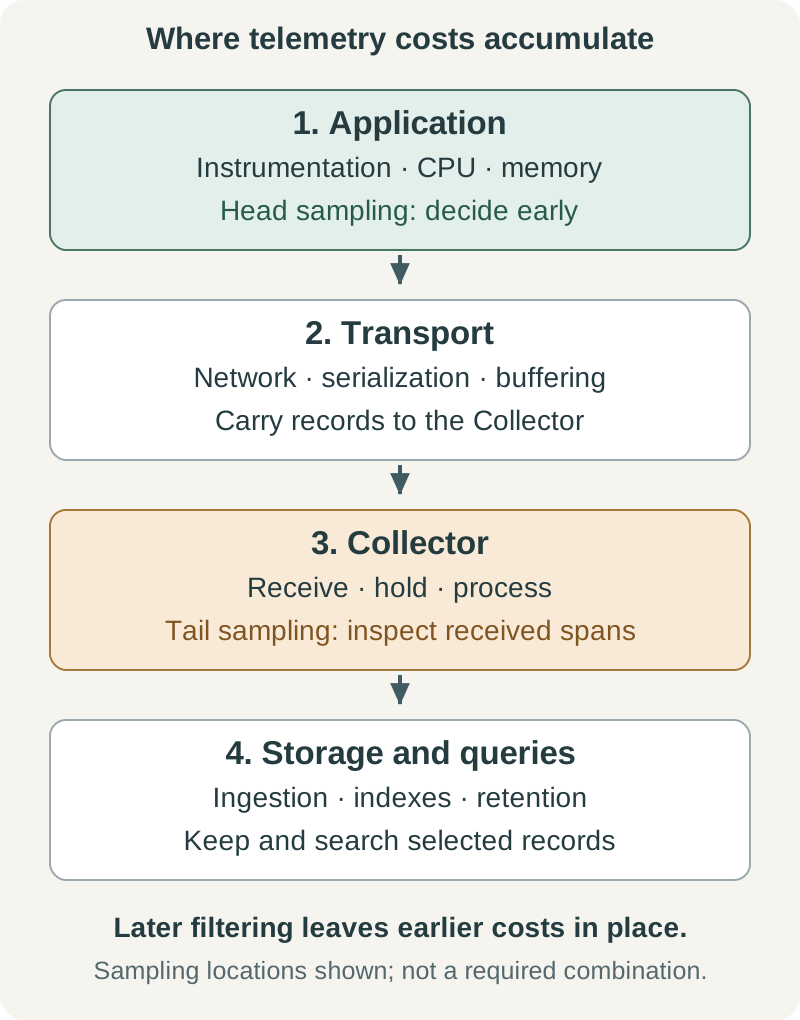
애플리케이션 성능 모니터링(Application Performance Monitoring, APM)을 비롯한 관측 도구의 비용은 저장 요금만이 아닙니다. 데이터를 측정하고 기록하는 데 쓰는 CPU·메모리, 네트워크 전송, 수집기(Collector)의 처리, 저장·검색, 운영자의 관리 시간까지 포함됩니다. 오픈소스로 직접 운영해도 이 자원과 운영 비용은 남습니다.
먼저 청구서와 운영 지표에서 큰 항목을 찾습니다. 수집량에 따른 요금이 큰지, 호스트 수에 따른 고정 요금이 큰지, 수집기 자원이나 검색 부하가 큰지에 따라 효과적인 조치가 다릅니다. 데이터량을 절반으로 줄였다고 전체 비용도 절반이 되지는 않습니다.
트레이스(trace)는 요청이 여러 작업을 거치는 경로와 시간을 연결한 기록입니다. 그 안의 API 처리나 DB 호출 같은 개별 작업 기록을 스팬(span)이라고 합니다. 초당 1,000요청, 요청당 평균 10스팬, 스팬당 평균 800바이트가 하루 내내 유지된다고 가정하면 원시 데이터는 약 691GB/일입니다.
requests_per_second = 1_000
spans_per_request = 10
bytes_per_span = 800
retained_fraction = 0.01

raw_gb_per_day = (
    requests_per_second * spans_per_request * bytes_per_span * 86_400 / 1_000_000_000
)
print(f"Raw: {raw_gb_per_day:.2f} GB/day")
print(f"Retained estimate: {raw_gb_per_day * retained_fraction:.2f} GB/day")
요청을 무작위로 1% 선택하고 표본의 평균 데이터 크기가 전체와 같다고 가정하면, 보존량은 약 6.9GB/일입니다. 압축·인덱스·복제·전송 부가 정보와 실제 요금 체계를 제외한 규모 계산 예시이며, 권장 수집 비율은 아닙니다. 느린 요청 중에서도 스팬 수가 많은 요청을 우선 보존하면 트레이스 보존 비율과 바이트 보존 비율도 달라집니다.
이 데이터가 모두 수집기에 도착한 뒤 99%를 버렸다면, 앞단의 생성·전송 부담은 그대로입니다. 계산한 저장량과 실제 줄어드는 비용을 구분해야 합니다.
보내기로 한 기록을 유지하면서 전송을 효율화하는 방법도 있습니다. 배치(batching)는 여러 기록을 묶어 보내 호출 횟수와 전송 부가 비용을 줄이고, 압축은 전송 바이트를 줄입니다. 집계처럼 여러 값을 요약하는 것은 아닙니다. 대신 배치를 기다리는 시간·버퍼 메모리·압축 CPU 비용을 확인해야 합니다. 청구 기준이 압축 전 용량이나 이벤트 건수라면 전송량 절감이 요금 절감으로 그대로 이어지지 않을 수 있습니다. OpenTelemetry 배치 처리
2. 기본 통계는 집계하고, 상세 기록은 선별한다
메트릭은 요청 수·오류 수·응답시간 분포를 통해 문제의 범위와 추세를 파악하는 데 사용합니다. 로그는 특정 사건의 맥락을, 트레이스는 요청 내부의 경로와 시간을 조사하는 데 사용합니다. 셋을 같은 비율로 줄일 필요는 없습니다. 실제 사용자 모니터링(Real User Monitoring, RUM)은 사용자 브라우저에서 경험을 측정하며, 별도의 수집 범위를 정합니다.
| 수집 대상 | 평소에 남길 근거 | 조사할 때 늘릴 범위 |
|---|---|---|
| 서비스 메트릭 | 전체 요청의 건수·오류·응답시간 분포를 집계 | 의심 경로의 대기·자원 포화 지표 |
| RUM | 일부 세션의 기본 통계와 느린 동작·오류의 상세 기록 | 문제 기기·버전·화면의 표본 |
| 트레이스 | 무작위 표본과 중요한 업무 경로의 기록 | 느린 요청·오류·새 버전의 기록 |
| 로그 | 사건을 구분하고 요청을 연결할 구조화 기록 | 대상 서비스·기간의 상세 로그 |
집계(aggregation)는 여러 관측값을 건수·합계·분포 등으로 요약하는 것입니다. 일부 요청만 골라 남기는 샘플링과 달리, 모든 요청을 통계에 반영하면서 개별 기록의 저장량을 줄일 수 있습니다. 예를 들어 요청 1,000건의 응답시간을 각각 저장하는 대신, 처리 경로별 요청 수·오류 수·응답시간 합계와 히스토그램을 남깁니다. 히스토그램은 응답시간을 구간별로 묶어 분포를 보존합니다.
집계할 때는 어떤 구분을 유지할지도 정해야 합니다. 인스턴스별 지표를 서비스별로 합치면 시계열 수를 줄일 수 있지만, 특정 인스턴스만 느렸는지는 집계 결과로 알 수 없습니다. 개별 요청의 순서나 원인도 요약 통계만으로 복원할 수 없으므로 필요한 로그·트레이스 표본을 함께 남깁니다. OpenTelemetry 메트릭 데이터 모델
비용 효과는 집계 위치에 따라 다릅니다. 애플리케이션에서 집계한 결과만 보내면 개별 기록을 보내는 것보다 전송량을 줄일 수 있습니다. 반면 수집기에서 합치면 그 이전 전송 비용은 남습니다. 조회할 때만 집계하거나 원본과 집계본을 모두 저장하는 것은 원본의 수집·저장량을 줄여주지 않습니다.
경보와 서비스 수준 목표(Service Level Objective, SLO)의 달성 여부를 계산하는 지표는 우선 보호합니다. 전체 요청 수라는 분모나 실패·지연 건수가 필터링으로 달라지면, 서비스가 그대로여도 지표만 좋아질 수 있습니다. 비용 정책을 바꿀 때는 경보 조건과 집계 대상이 유지되는지도 확인합니다. 서비스 수준 목표의 정의
중요한 업무는 트래픽 비중만으로 판단하지 않습니다. 하루에 몇 번 실행되지 않는 정산 작업은 전체 요청의 1% 무작위 표본에서 빠질 수 있습니다. 이런 경로는 별도 수집 대상으로 두고, 성공과 실패 양쪽의 기록이 실제로 남는지 확인합니다.
3. 트레이스는 언제 선택하느냐에 따라 비용이 달라진다
샘플링(sampling)은 전체 중 일부를 선택해 남기는 방식입니다. Head sampling은 트레이스가 시작할 때 선택하므로 상세 스팬의 생성과 전송 부담을 줄이는 데 유리합니다. 다만 시작 시점에는 최종 지연이나 오류를 알 수 없습니다.
Tail sampling은 도착한 스팬을 모아 지연·오류 등을 보고 보존 여부를 정합니다. 문제 요청을 고르기 좋지만, 판단 전까지 받아서 보관할 수집기 자원이 필요합니다. 앞단의 head sampling에서 버린 트레이스는 복원할 수 없습니다. OpenTelemetry 샘플링 설명
계측·전송 부담이 크다면 head sampling을, 최종 결과를 보고 문제 요청을 선별해야 한다면 tail sampling을 검토합니다. 두 방식을 조합할 때도 앞단에서 제외한 기록은 뒤에서 선택할 수 없다는 제약을 고려합니다.
Tail sampling에서는 같은 트레이스의 스팬을 같은 판단 지점으로 모아야 합니다. 늦게 도착한 스팬, 결정 대기 시간, 메모리 한도 때문에 기록이 불완전해질 수 있습니다. “오류를 보존한다”는 정책과 “모든 오류 기록이 도착한다”는 보장은 다릅니다. Tail sampling processor 문서
오류와 느린 요청을 우선 남긴 집합은 의도적으로 편향되어 있습니다. 그 집합의 평균이나 p99를 전체 서비스의 응답시간으로 읽지 않습니다. p99는 관측값의 99%가 그 이하인 경계값을 뜻합니다. 전체 상태를 판단할 메트릭은 이러한 보존 정책과 독립적으로 집계해야 합니다.
4. RUM은 측정 대상과 상세 전송량을 따로 조절한다
RUM은 서비스에 포함한 자바스크립트가 실제 사용자의 브라우저에서 측정하고 결과를 전송하는 방식으로 운영할 수 있습니다. 사용자가 개발자 도구를 열거나 측정 버튼을 누를 필요는 없습니다.
예를 들어 세션의 5%를 무작위로 선택하고, 선택된 세션에서는 정상 동작을 포함한 기본 통계를 남기되 느리거나 실패한 동작만 상세 전송할 수 있습니다. 5%는 설명을 위한 예시입니다. 세션 선택은 측정 대상의 범위를, 상세 전송 조건은 보내고 저장할 양을 조절합니다. 비율뿐 아니라 화면·기기별로 실제 몇 건이 남는지도 확인해야 합니다. 표본이 너무 적으면 드문 오류를 놓치거나 지연 분포를 안정적으로 비교하기 어렵습니다.
모든 브라우저가 측정용 라이브러리를 내려받고 초기화한 뒤 표본을 고른다면 초기 로딩 비용은 남습니다. 선택된 브라우저에서도 임계치 판정을 위한 측정과 임시 보관은 필요합니다. 전송량뿐 아니라 브라우저의 CPU·메모리와 페이지 로딩 영향도 확인합니다.
장애 중에는 느린 동작이 늘어 상세 이벤트가 급증할 수 있습니다. 이벤트 크기·개수와 브라우저 버퍼에 한도를 두고, 한도 때문에 생략한 건수도 남깁니다. 기본 통계와 상세 기록의 한도를 구분하면 상세 이벤트 급증으로 기본 통계까지 밀리는 상황을 줄일 수 있습니다.
특정 기기나 버전의 표본을 늘렸다면 선택 조건·비율·적용 기간을 함께 기록합니다. 선택 확률이 다른 데이터를 구분 없이 합쳐 전체 사용자의 분포처럼 해석하지 않고, 정책 변경 전후를 비교할 기본 표본을 유지합니다.
5. 불필요한 기록·필드를 걸러내고 레이블 수를 관리한다
필터링(filtering)은 정한 조건에 따라 불필요한 기록이나 필드를 제외하는 것입니다. 정상 상태 확인 요청의 상세 로그, 쓰이지 않는 속성, 중복 수집부터 검토하되 필요한 가용성 지표와 오류 기록까지 제거하지 않습니다. 요청 본문은 필요한 필드만 남기고 인증 토큰은 기록에서 제외하는 등, 생성 단계에서 수집 범위를 정합니다. 수집기에서도 필터링할 수 있지만, 이미 발생한 앞단 비용은 남습니다. OpenTelemetry 필터링과 속성 처리
로그를 줄일 때는 수준을 일괄적으로 낮추기보다 반복되는 내용을 먼저 찾습니다. 같은 오류가 수만 번 발생한다면 전체 발생 건수는 메트릭으로 집계하고, 상세 로그는 일부만 보존하는 방식을 검토할 수 있습니다. 생략한 건수를 함께 남겨야 로그 수를 실제 오류 수로 오해하지 않습니다.
남길 로그에는 발생 시각, 서비스·버전, 처리 경로, 결과·오류 유형, 요청 ID나 트레이스 ID처럼 기록을 연결할 정보를 둡니다. 요청·응답 본문 전체가 없어도 이 정보로 조사할 수 있는지 먼저 확인합니다. 감사·거래 기록처럼 누락을 허용할 수 없는 데이터는 진단용 로그와 목적을 구분해 정책을 정합니다.
메트릭에서는 카디널리티(cardinality), 즉 서로 다른 레이블 조합의 수가 중요합니다. 레이블은 메트릭을 경로나 리전 등으로 나눠 보는 이름표입니다. 같은 메트릭 이름과 레이블 조합의 측정값을 시간 순서대로 쌓은 기록이 시계열입니다. 가상의 요청 카운터에 경로 20개, 리전 3개, 결과 유형 5개가 있고 모든 조합이 발생한다면 300개의 시계열이 만들어집니다. 여기에 요청마다 다른 ID까지 붙이면 요청이 늘 때마다 새 조합이 생깁니다. 실제 수에는 인스턴스 등 다른 레이블도 영향을 줍니다.
경로는 route="/orders/{id}"처럼 정규화하고, 사용자 ID·요청 ID·전체 URL처럼 값이 계속 늘어나는 항목은 메트릭 레이블에서 제외합니다. 필요한 식별자는 로그나 트레이스에 남기되, 그곳에서도 보존 기간과 검색용 인덱스의 비용을 확인합니다. Prometheus 레이블 지침
6. 보존 기간과 검색 속도를 함께 설계한다
모든 데이터를 같은 기간 보관할 필요는 없습니다. 상세 기록은 개별 원인을 조사하는 데, 장기 통계는 배포 전후나 주간·월간 추세를 비교하는 데 사용합니다. 다만 “상세 데이터는 짧게”라는 원칙만으로 기간을 정하면 주말이 지난 뒤 발견한 문제의 기록이 이미 사라질 수 있습니다.
최근 장애에서 문제가 발생한 뒤 발견하고 조사에 착수하기까지 얼마나 걸렸는지 확인합니다. 이 시간과 후속 조사에 필요한 기간을 바탕으로 기본 보존 기간을 정하고, 진행 중인 조사에 필요한 기록은 만료 전에 별도로 보존합니다. 감사 목적 등 별도 요구가 있는 기록은 그 기준을 따릅니다.
보존 기간과 별개로 저장 계층(tiering)도 선택할 수 있습니다. 자주 조회하는 최근 데이터는 빠른 저장소에, 오래되어 드물게 조회하는 기록은 저렴한 계층에 두는 방식입니다. 제품에 따라 검색이 느려지거나 복원 과정이 필요하므로, 보관료뿐 아니라 복원·조회 비용과 조사 시작까지 기다릴 시간을 함께 계산합니다. Elastic의 데이터 계층 예시
검색용 인덱스의 범위와 반복 조회도 확인합니다. 필요한 필드 위주로 인덱싱하고, 대시보드의 조회 기간·갱신 주기와 반복 계산을 조절할 수 있습니다. 다만 인덱스를 줄이면 검색이 느려질 수 있고, 미리 계산한 결과를 저장하면 추가 저장량이 생깁니다. 실제로 자주 수행하는 장애 조사 쿼리로 비용과 응답시간을 함께 비교합니다.
장기 보존에는 시간 단위의 집계도 활용할 수 있습니다. 최근 데이터는 10초 단위로, 오래된 데이터는 5분 단위로 요약해 보관하는 식입니다. 이는 예시이며, 짧은 지연 급증의 발생 시점은 덜 정밀하게 보입니다.
이때 p99 숫자를 평균 내어 5분 p99를 만들 수는 없습니다. 해당 기간의 응답시간 합계와 건수로 평균을 구하고, 호환되는 히스토그램을 합쳐 백분위수를 추정합니다. 구간·해상도와 집계 호환성도 확인합니다. Prometheus 히스토그램과 요약 설명
누적 카운터의 측정값을 시간 순서대로 더하면 같은 요청을 여러 번 셀 수 있습니다. 각 시계열에서 재시작에 따른 초기화를 고려해 해당 기간의 증가량을 구한 뒤 합쳐야 합니다. Prometheus에서는 rate()나 increase()를 각 시계열에 먼저 적용하고 집계합니다. CPU 사용률 같은 현재 상태값은 카운터가 아니므로 같은 방식으로 처리하지 않습니다. Prometheus의 카운터 집계 순서
보존 기간을 줄이면 저장 부담은 줄일 수 있지만, 하루 유입량이나 계측 부담은 바뀌지 않습니다. 반대로 메트릭 수집 간격을 늘리면 수집되는 측정점은 줄어도 짧은 순간의 변화가 덜 보일 수 있습니다. 줄이려는 비용과 잃게 되는 시간 해상도를 함께 판단합니다.
7. 비용을 줄인 뒤에도 같은 문제를 조사할 수 있는지 확인한다
새 정책은 처음부터 전체에 적용하기보다 대상 서비스나 트래픽 일부에서 검증합니다. 예를 들어 주문 목록이 느려지는 문제를 조사한다고 가정해 봅니다. 새 정책에서도 다음 근거를 찾을 수 있어야 합니다.
- 문제가 집중된 시간·버전·기기를 기본 통계에서 구분할 수 있는가?
- 느린 동작을 해당 요청의 로그·트레이스와 연결할 수 있는가?
- 지연이 발생한 작업과 정상 요청의 차이를 비교할 수 있는가?
브라우저와 서버가 각각 독립적으로 표본을 선택하면, 브라우저에 남은 느린 동작의 서버 트레이스는 없을 수 있습니다. 연결 ID가 있다는 것만으로 양쪽 기록이 보존되지는 않습니다. 중요한 경로는 선택·보존 정책을 함께 설계하고, 실제로 연결 가능한 기록이 얼마나 남는지 확인합니다.
기존 기록에 새 필터를 적용하면 무엇이 남고 사라지는지 검토할 수 있습니다. 다만 브라우저·애플리케이션의 계측 부하, 수집기의 버퍼 부족, 실제 전송 누락까지 재현하지는 못하므로 제한된 운영 적용에서도 확인해야 합니다.
의도적으로 덜 남긴 것과, 과부하로 잃어버린 것은 구분해야 합니다. 수집기의 대기열 사용량, 처리 거부·폐기 건수, 전송 실패와 최종 누락을 함께 봅니다. 재시도가 성공한 일시적 전송 실패를 모두 영구 누락으로 세지는 않습니다. 대기열이 가득 차거나 재시도 한도를 넘으면 수집 정책과 무관하게 기록을 잃을 수 있습니다. OpenTelemetry 수집기 복원력 설명
정책에는 다음 다섯 가지를 남깁니다.
- 각 데이터로 답할 질문과 필요한 연결 정보
- 기본 수집 범위·표본 비율·집계 단위와 그에 따라 잃는 정보
- 시계열 수·하루 유입량·보존 기간·수집기 자원과 검색·복원 비용의 한도
- 조사 중 수집을 늘릴 대상·종료 시점과 자동 복귀 설정
- 비용 변화, 필요한 기록을 찾은 비율, 원인을 좁히는 데 걸린 시간
각 정책의 담당자와 재검토 시점도 정해 둡니다. 트래픽과 서비스 구성이 바뀌면 처음 정한 한도가 더는 적절하지 않을 수 있습니다.
관측 비용의 적정선은 하나의 샘플링 비율로 정할 수 없습니다. 필요한 문제를 조사할 근거를 확보한 뒤, 반복되거나 쓰이지 않는 상세 데이터부터 줄여 나갑니다. 수집 정책의 성과는 절감한 비용과 다음 장애를 설명할 능력으로 함께 평가해야 합니다.
함께 읽기 좋은 글
- 웹 애플리케이션은 어디서 느려지는가: 문제 구간을 좁히는 조사 순서 — 관측 데이터로 실제 성능 문제의 범위를 좁히는 방법을 다룹니다.
- 메트릭은 당겨야 할까, 밀어야 할까: Pull과 Push 수집 방식 비교 — 수집 경로의 실패, 버퍼링과 운영 책임을 함께 검토할 수 있습니다.